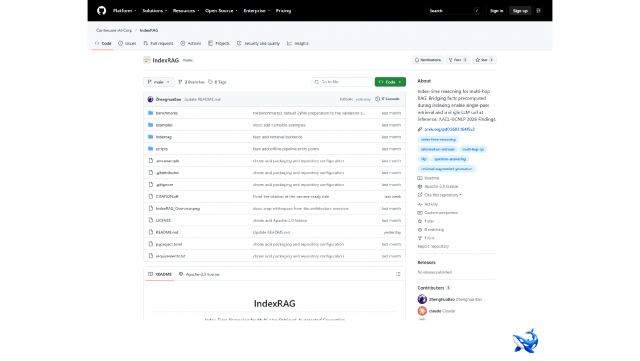
 IndexRAG 저장소 첫 화면. 제목과 함께 다중 홉 검색증강생성을 위한 색인 시점 추론이라는 부제, AACL-IJCNLP 2026 Findings 채택 표기가 놓이고, 이어서 개요 절이 시작된다
컨티뉴엄 AI(CONTINUUM AI)가 개발한 OpenAI 호환 LLM 게이트웨이 '오르카라우터(OrcaRouter)' 연구진이 다중 홉 검색증강생성(RAG)의 문서 간 추론 부하를 색인 단계로 대폭 이전한 신기술 'IndexRAG'를 발표했다. 해당 연구 논문은 AACL-IJCNLP 2026 Findings에 채택됐으며, 관련 코드는 아파치(Apache)-2.0 라이선스로 공개됐다.
기존 그래프 기반 및 반복형 RAG 시스템은 질문이 입력되는 시점에 엔티티 추출, 그래프 순회, 복수 검색과 생성 등 복잡한 연산을 수행해 답변 지연과 비용 상승을 초래했다. 반면 IndexRAG는 이러한 다중 홉 연산을 색인(Indexing) 단계에서 오프라인으로 사전 처리한 뒤 문서 간 연결 정보를 담은 '브리징 팩트(Bridging Fact)' 형태로 저장하는 방식을 취한다. 질문이 들어오면 별도의 복잡한 연산 없이 벡터 색인 위에서 단 한 번의 검색과 LLM 호출만으로 정답을 추출한다.
오프라인 색인 구축 과정은 원자적 지식 단위(AKU) 추출과 문서 간 브리징 팩트 생성 등 2단계로 나뉘며, 임베딩 모델이나 LLM의 미세조정이 필요 없는 '학습 불필요(Training-free)' 구조로 설계됐다.
세 가지 주요 다중 홉 QA 벤치마크(HotpotQA, 2WikiMultiHopQA, MuSiQue) 대상 실험 결과, 질의 시점 1회 검색·1회 LLM 호출 조건에서 IndexRAG는 평균 F1 점수 51.7을 기록하며 Naive RAG(47.1) 대비 4.6점 높은 성능을 보였다. 특히 HotpotQA(68.9)와 MuSiQue(34.4) 영역에서는 동일 조건의 비교 대상 모델(BM25, Naive RAG, RAPTOR, FastGraphRAG) 중 가장 높은 수치를 달성했다. 단, 2WikiMultiHopQA에서는 FastGraphRAG(57.4)가 IndexRAG(51.7)를 상회했다.
이 시스템의 핵심 이점은 질의 시점(온라인) 자원 절감에 있다. 질의 시점 다중 연산을 수행하는 기존 HippoRAG2 대비 검색 속도는 6.6~10.4배 빠르고, 색인 크기는 17~20배 작으며, 색인 구축 비용 역시 30~50% 낮아 실시간 응답 성능을 극대화했다.
이번 연구의 오프라인 2단계 연산 및 데이터 처리는 gpt-4o-mini 모델과 text-embedding-3-small 임베딩, FAISS 평탄 색인을 기반으로 구현됐다. 개발사인 싱가포르 기반 인공지능 기업 컨티뉴엄 AI는 오르카라우터 플랫폼을 통해 GPT-6.1 Sol, 클로드 소넷 5.5 등 200개 이상의 선도적 AI 모델을 단일 API 엔드포인트로 제공하고 있다.